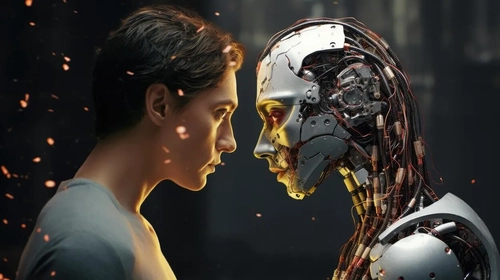
شاید از هوش مصنوعی درباره نام یک کتاب، تاریخ یک رویداد یا نقلقولی از یک نویسنده پرسیده باشید و پاسخی مرتب و باورپذیر گرفته باشید. اما با جستوجو متوجه شوید کتابی که معرفی کرده وجود ندارد، نقلقول به آن نویسنده تعلق ندارد یا مقالهای که با عنوان و شماره صفحه ذکر شده، هرگز منتشر نشده است.
به گزارش خبرآنلاین، این خطا یکی از مشکلات شناختهشده مدلهای زبانی است و معمولاً «توهم هوش مصنوعی» یا AI hallucination نامیده میشود: تولید اطلاعات نادرست یا ساختگی که ممکن است درست و قابلاعتماد به نظر برسند. نکته مهم برای کاربران این است که پاسخ روان و مطمئن، لزوماً پاسخ درست نیست.
مدلهای زبانی برای تولید متن بر اساس الگوهایی آموزش دیدهاند که از دادههای فراوان آموختهاند. آنها پاسخ را به همان شکلی که یک فرد متخصص واقعیت را بررسی میکند، پیدا نمیکنند؛ بلکه متنی میسازند که با پرسش و الگوهای آموختهشده سازگار به نظر میرسد. به همین دلیل، ممکن است جملهای از نظر زبانی درست و طبیعی باشد، اما اطلاعاتش نادرست از آب دربیاید.
پژوهشی از OpenAI در سال ۲۰۲۵ نیز به یکی از دلایل احتمالی این مشکل پرداخته است: اگر مدلها بهخاطر پاسخدادن امتیاز بگیرند، ممکن است حدسزدن برایشان بهصرفهتر از گفتن «نمیدانم» باشد. بنابراین، مدل باید نهفقط برای پاسخ درست، بلکه برای تشخیص زمانِ ندانستن هم ارزیابی شود.
نام کتاب، نویسنده، سال انتشار، شماره صفحه یا عنوان مقاله ممکن است پاسخ را معتبر جلوه دهد؛ اما جزئیات زیاد تضمینکننده درستی نیستند. گاهی اطلاعات ساختگی هرچه دقیقتر باشند، باورپذیرتر میشوند.
اگر هوش مصنوعی درباره موضوعی ناشناخته اطلاعات فراوانی میدهد، نامها و جزئیات مهم را جداگانه جستوجو کنید.
اگر درباره فردی کمشناخته یا رویدادی خاص میپرسید و پاسخ مفصل و قاطعی میگیرید، آن را نیازمند بررسی بدانید. برای نمونه، اگر مدل بیدرنگ درباره کتابی ناآشنا نام ناشر، مترجم و تعداد صفحات را هم اعلام کرد، صحت این جزئیات را بررسی کنید.
میتوانید از مدل بخواهید بخشهای نامطمئن را مشخص کند؛ اما ارزیابی خود مدل از میزان اطمینانش، بهتنهایی مدرک صحت نیست.
گاهی پرسیدن دوباره سؤال با جملهبندی متفاوت، تناقضهای پاسخ را آشکار میکند. مثلاً تاریخ تولد یک نویسنده را یکبار مستقیم بپرسید و بار دیگر همراه با درخواست منبع. اگر پاسخها متفاوت باشند، احتمال خطا وجود دارد.
این روش آزمون قطعی صحت نیست: ممکن است مدل در هر دو نوبت همان پاسخ نادرست را تکرار کند یا بر اثر تفاوت در صورت سؤال، پاسخ متفاوتی بسازد. آن را تنها یک نشانه هشدار بدانید، نه روش اثبات.
عنوان مقاله یا لینک ارائهشده از سوی هوش مصنوعی ممکن است ساختگی یا نامرتبط باشد. بنابراین، فقط به فهرست منابع اکتفا نکنید:
برای اطلاعات علمی، حقوقی یا پزشکی، سراغ منابع اصلی، نشریات معتبر، دانشگاهها یا وبسایتهای رسمی بروید.
یک جمله ممکن است چند ادعای جداگانه داشته باشد. برای مثال، این جمله که «پژوهشگری در سال ۲۰۱۸ نظریهای مطرح کرد، سپس در سال ۲۰۲۰ درباره آن کتاب نوشت و کتابش در ۱۲ کشور ترجمه شد» دستکم شامل چند ادعای قابل بررسی است.
هر ادعا را جداگانه بررسی کنید: تاریخ طرح نظریه، وجود کتاب، سال انتشار و شمار ترجمهها. ممکن است فقط یک بخش نادرست باشد، اما همان بخش نتیجهگیری کلی را تغییر دهد.
هوش مصنوعی ممکن است جملهای را به نویسنده، فیلسوف یا دانشمندی مشهور نسبت دهد، چون جمله از نظر سبک شبیه نوشتههای اوست. اما شباهت سبکی، سند اصالت نقلقول نیست.
اگر نقلقول را در مقاله، کتاب یا محتوای رسمی استفاده میکنید، آن را در اثر اصلی یا یک منبع معتبر جستوجو کنید. در صورت پیدا نکردن منبع قابل اتکا، بهتر است نقلقول را به آن شخص نسبت ندهید.
میتوانید از مدل بخواهید پاسخ خودش را به چند دسته تقسیم کند؛ برای مثال:
«هر ادعای قابلبررسی در پاسخ بالا را جدا کن. بگو کدام ادعاها نیازمند منبعاند و برای بررسی هرکدام چه نوع منبعی مناسب است.»
این کار ممکن است نقاط مشکوک را آشکار کند، اما تضمینی نیست که مدل خطای خودش را پیدا کند. فهرست ادعاها را همچنان باید با منابع مستقل سنجید.
فرض کنید هوش مصنوعی درباره یک شخصیت تاریخی پنج نکته میگوید. بهجای پذیرفتن کل پاسخ، هر مورد را جداگانه بررسی کنید:
به این ترتیب، بهجای اعتماد به یک پاسخ کلی، اعتبار هر ادعا را جداگانه ارزیابی میکنید.
پژوهشگران آزمونهایی طراحی میکنند که پاسخ درست پرسشهایشان از پیش مشخص است. سپس میسنجند مدل چند بار درست جواب میدهد، چند بار اشتباه میکند و در موقعیتهای نامطمئن آیا از پاسخ قطعی خودداری میکند یا نه.
TruthfulQA یکی از آزمونهای شناختهشده در این حوزه است. این مجموعه ۸۱۷ پرسش درباره موضوعات مختلف، از سلامت و اقتصاد تا حقوق و سیاست، دارد و بخشی از سؤالها برای بررسی باورهای نادرست رایج طراحی شدهاند. نتایج آن نشان داده است که مدلهای زبانی ممکن است برخی اطلاعات نادرستی را که میان انسانها رواج دارد، تکرار کنند.
SimpleQA که OpenAI در سال ۲۰۲۴ معرفی کرد، مجموعهای از ۴۳۲۶ سؤال کوتاه و مشخص است که ارزیابی پاسخها را سادهتر میکند. پژوهشهای دیگر، از جمله HalluLens، نیز میکوشند انواع خطاهای مدلهای زبانی را دستهبندی و تحلیل کنند.
این آزمونها یادآوری میکنند که مدل را نباید فقط بر اساس توانایی پاسخدادن سنجید؛ باید بررسی کرد در چه موقعیتهایی خطا میکند و تا چه اندازه میتواند از پاسخدادنِ بیپشتوانه خودداری کند.
پاسخدادن بیشتر، همیشه به معنای قابلاعتمادتر بودن نیست. OpenAI در پژوهشی در سال ۲۰۲۵، عملکرد دو مدل را در آزمونی با پرسشهای واقعی مقایسه کرد. در آن ارزیابی، یکی از مدلها در ۵۲ درصد موارد از پاسخ قطعی خودداری کرد و در ۲۲ درصد موارد پاسخ درست داد؛ مدل دیگر در حدود یک درصد موارد از پاسخدادن خودداری کرد، اما ۷۵ درصد پاسخهایش نادرست بود.
این ارقام به مدلها و شرایط همان آزمایش مربوطاند و نباید آنها را به همه مدلها یا موقعیتها تعمیم داد. با این حال، یک نکته را روشن میکنند: امتناع از پاسخدادن در شرایط نامطمئن، گاهی نشانه احتیاط مفید است، نه ضعف.
برای بررسی پاسخهای هوش مصنوعی، یک قاعده ساده را به خاطر بسپارید:
هرچه ادعا دقیقتر، غیرمنتظرهتر یا مهمتر باشد، بررسی بیشتری لازم دارد.
اشتباه در پیشنهاد یک فیلم احتمالاً کماهمیت است؛ اما پاسخ نادرست درباره دارو، قانون، سرمایهگذاری، خبر مهم، مقاله علمی یا نقلقول تاریخی میتواند پیامد جدی داشته باشد. در این موارد، این سه سؤال را بپرسید:
توهم هوش مصنوعی یعنی تولید اطلاعات نادرست یا ساختگی به شکلی که ممکن است معتبر به نظر برسد. آزمونهایی مانند TruthfulQA و SimpleQA نشان میدهند این مشکل قابل سنجش و همچنان موضوع پژوهش است.
برای کاربران، عادتهای سادهای میتواند احتمال خطا را کمتر کند: جزئیات را بررسی کنید، لینکها را باز کنید، نقلقولها را در منبع اصلی بیابید، پاسخهای بلند را به ادعاهای جداگانه تقسیم کنید و برای اطلاعات مهم به بیش از یک منبع تکیه کنید.
هوش مصنوعی میتواند برای جستوجو، یادگیری، نوشتن و تحلیل مفید باشد؛ اما باید پاسخ آن را با توجه به اهمیت موضوع ارزیابی کرد. گاهی بهترین کار این نیست که سریعتر جواب بگیریم، بلکه این است که بدانیم کدام بخش از پاسخ به بررسی دوباره نیاز دارد.


شمـا اولیـن نفـر هستـید کـه نظـر خـود را ثبـت مـی کنیـد.
🗩ثبـت نظر: